19 kwi 20215 min czytania

Jak prognozuje International Data Corporation, światowe przychody z rozwiązań Big Data i Business Analytics miały do końca 2020 roku sięgnąć 260 miliardów dolarów. Nic dziwnego - analityka danych pomaga firmom przewidywać potrzeby klientów, personalizować podejście do nich, zapobiegać awariom i podejmować lepsze decyzje biznesowe.
W efekcie popularność analityki danych stale rośnie. Jeśli w 2015 roku z analityki big data korzystało tylko 17% firm, to w 2017 odsetek ten wzrósł do 53% i rośnie z każdym rokiem.
Żeby dołączyć do czołowych firm, które korzystają z danych i wiele na tym zyskują, trzeba znać przynajmniej jeden język programowania używany w data science.
W tym artykule przyjrzymy się jednemu z najczęściej używanych języków data science - Pythonowi. Sprawdź, czy Python nadaje się do analizy danych, jak go w niej wykorzystać, jakie ma zalety i wady oraz jakie są alternatywy w analityce danych.
Czy Python nadaje się do analizy danych?
Python pojawił się już w 1990 roku, ale popularność zaczął zdobywać dopiero kilka lat temu. W 2020 roku Python stał się czwartym najczęściej używanym językiem po JavaScripcie, HTML/CSS i SQL - używało go 44,1% programistów.
Python to interpretowany język wysokiego poziomu ogólnego przeznaczenia o podejściu obiektowym. Używa się go do tworzenia API, sztucznej inteligencji, stron internetowych, Internetu rzeczy itd.
Python stał się tak popularny między innymi dlatego, że jest szeroko używany wśród data scientistów. To jeden z najłatwiejszych języków do nauki, ma imponujące biblioteki i świetnie sprawdza się na każdym etapie data science.
Krótka odpowiedź na pytanie, czy Python nadaje się do analizy danych, brzmi więc: tak. Jego zalety i wady omówimy w dalszej części artykułu, więc zostań z nami po bardziej szczegółowe wyjaśnienie.
Jak używa się Pythona w analizie danych?
Jak wspomnieliśmy, Python sprawdza się na każdym etapie analizy danych. To właśnie biblioteki Pythona zaprojektowane pod data science są tak pomocne. Eksploracja danych, przetwarzanie i modelowanie danych wraz z wizualizacją danych to 3 najpopularniejsze sposoby wykorzystania Pythona w analizie danych.
Eksploracja danych
Inżynier danych korzysta z bibliotek takich jak Scrapy i BeautifulSoup do eksploracji danych w Pythonie. Za pomocą Scrapy można zbudować specjalne programy zbierające ustrukturyzowane dane z sieci. Jest też szeroko używany do pobierania danych z API.
BeautifulSoup przydaje się, gdy nie da się pobrać danych z API: zbiera dane i układa je w preferowanym formacie.
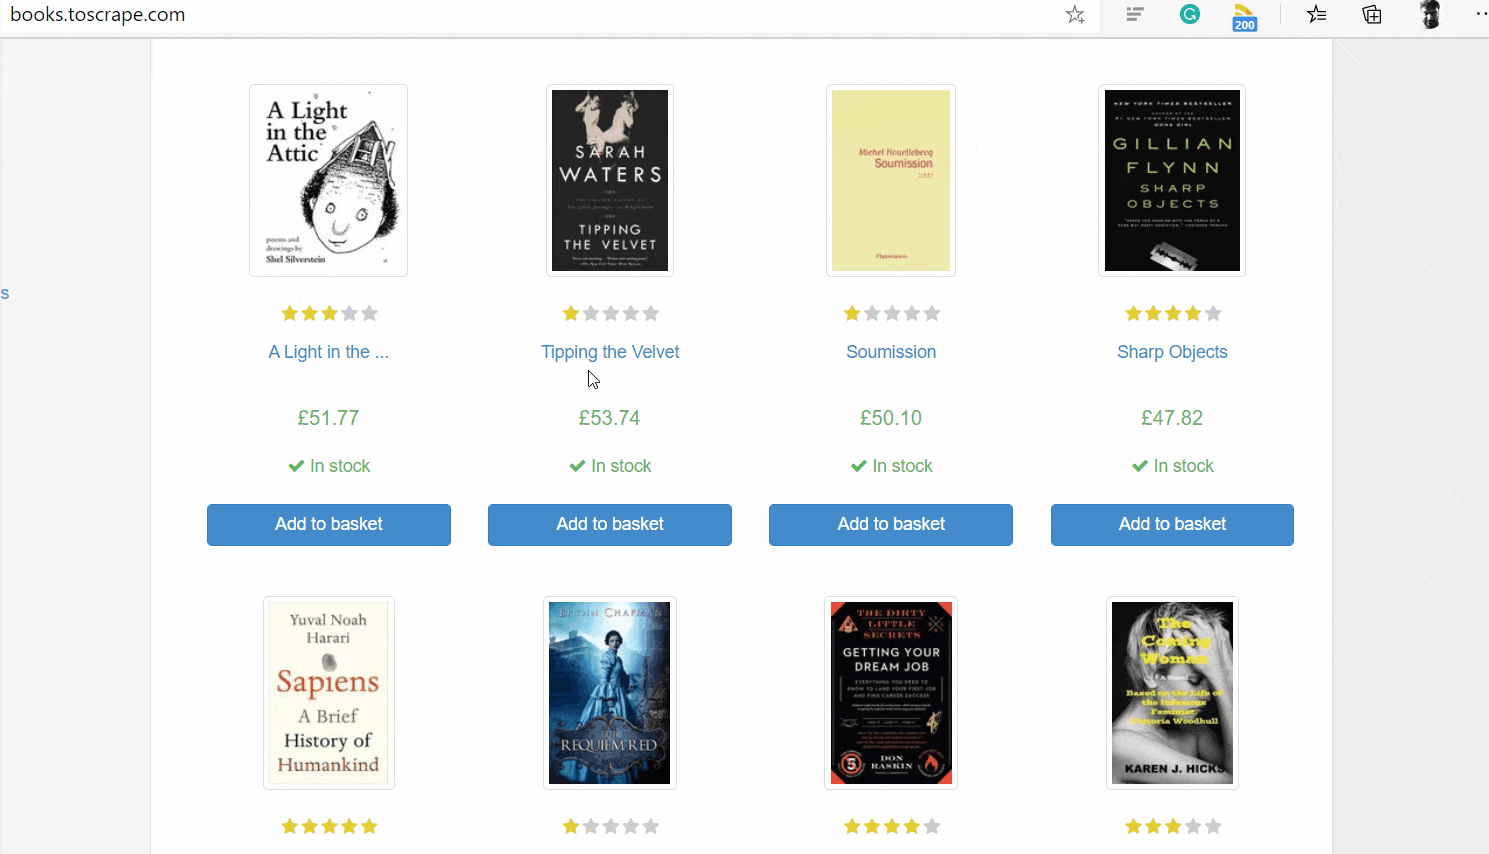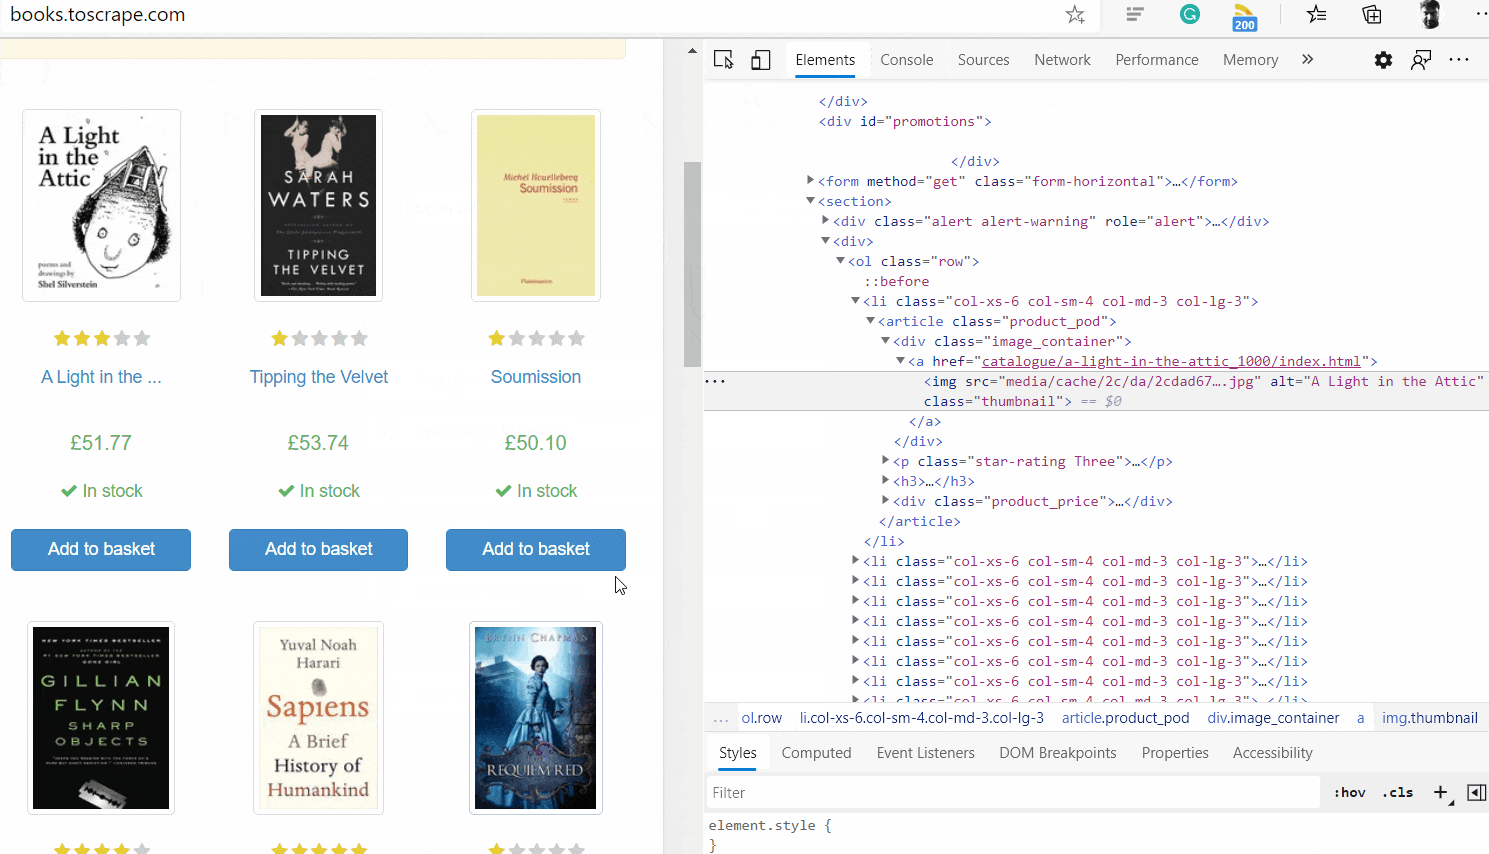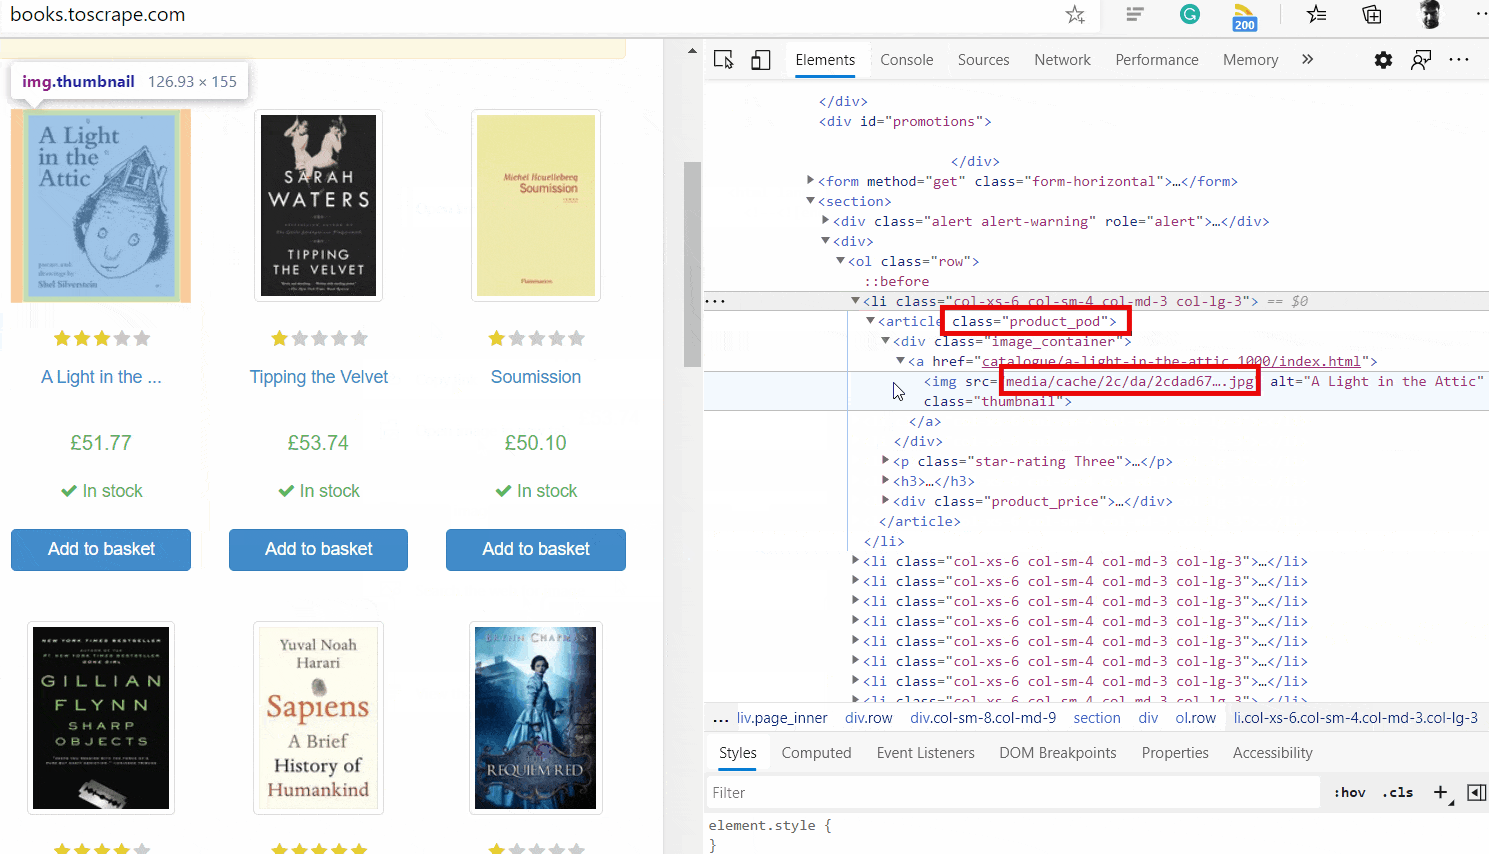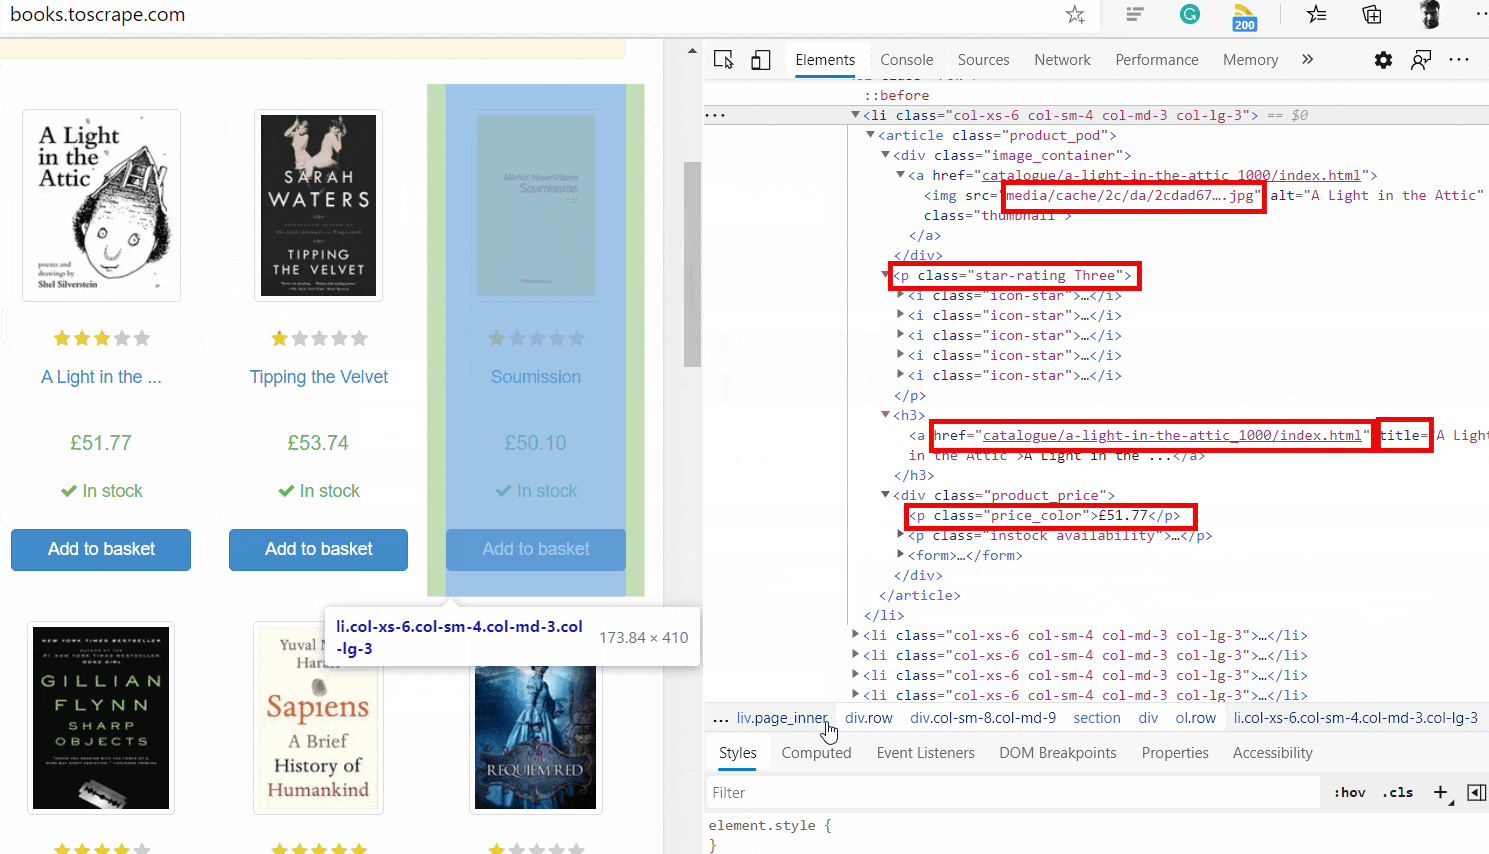
BeautifulSoup w akcji - zbieranie danych z sieci
Źródło: Stackabuse.com
Przetwarzanie i modelowanie danych
Na tym etapie używa się dwóch głównych bibliotek: NumPy i Pandas. NumPy (Numerical Python) służy do porządkowania dużych zbiorów danych i ułatwia operacje matematyczne oraz ich wektoryzację na tablicach. Pandas oferuje dwie struktury danych: serie (lista elementów) i ramki danych (tabela z wieloma kolumnami). Ta biblioteka konwertuje dane do ramki danych, pozwalając usuwać i dodawać kolumny oraz wykonywać różne operacje.
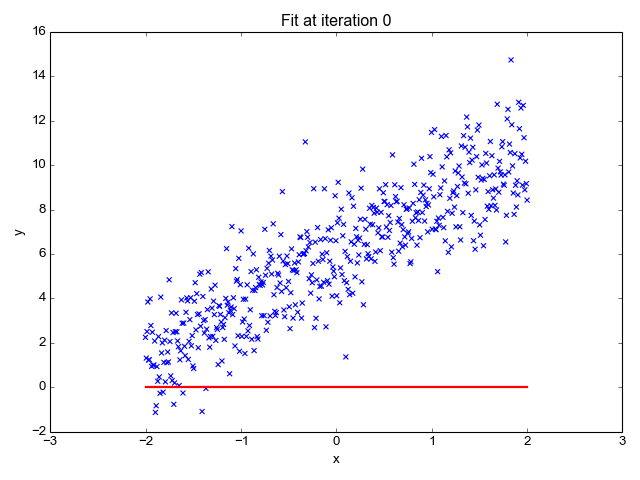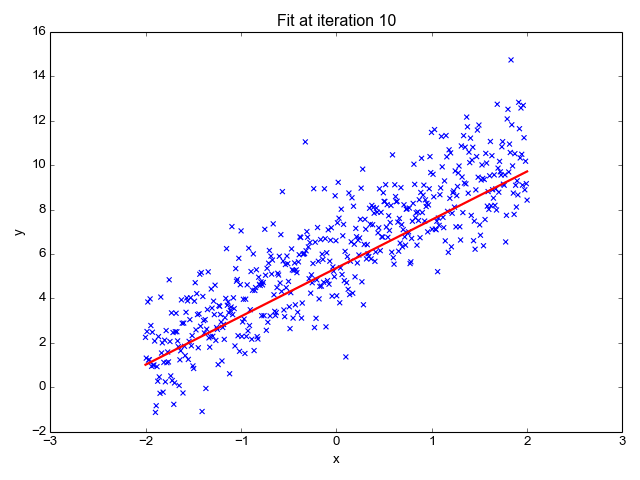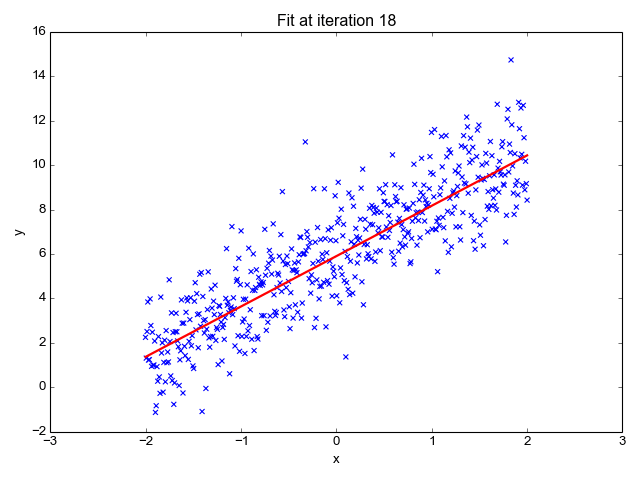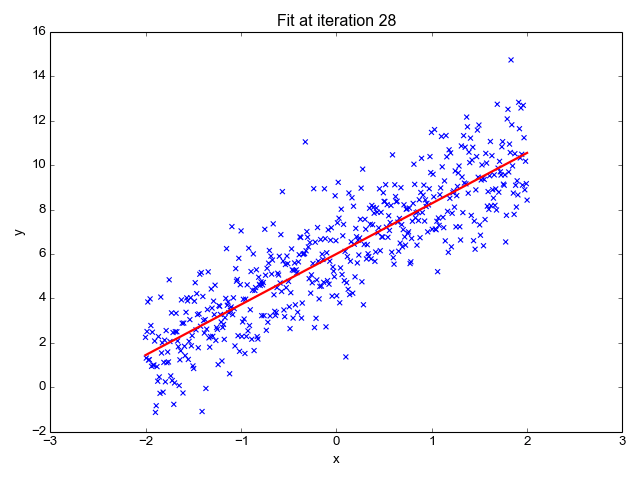
Modelowanie regresji liniowej w NumPy
Wizualizacja danych
Matplotlib i Seaborn są szeroko używane do wizualizacji danych w Pythonie. Oznacza to, że pomagają zamienić długie listy liczb na czytelne wykresy, histogramy, wykresy kołowe, mapy ciepła itd.
Oczywiście istnieje znacznie więcej bibliotek niż te, które wymieniliśmy. Python oferuje mnóstwo narzędzi do projektów analizy danych i pomaga przy każdym zadaniu w tym procesie.
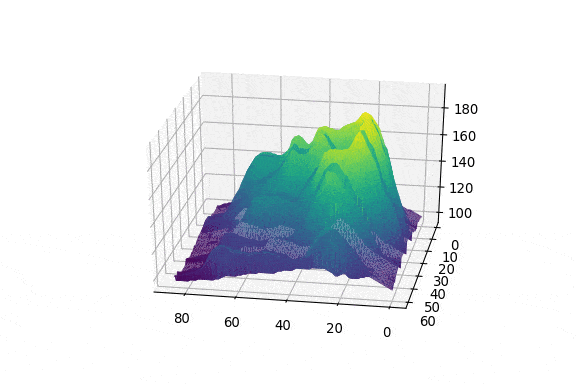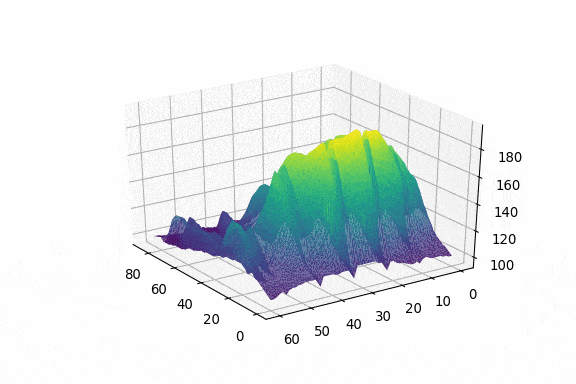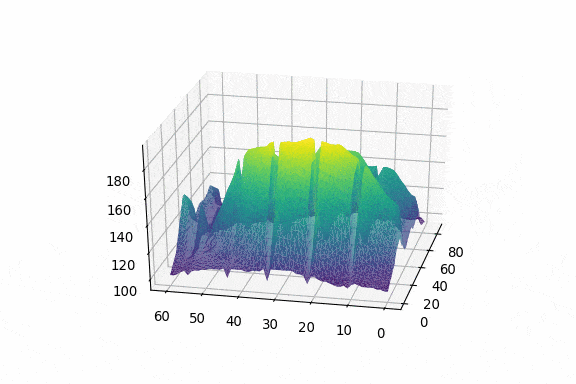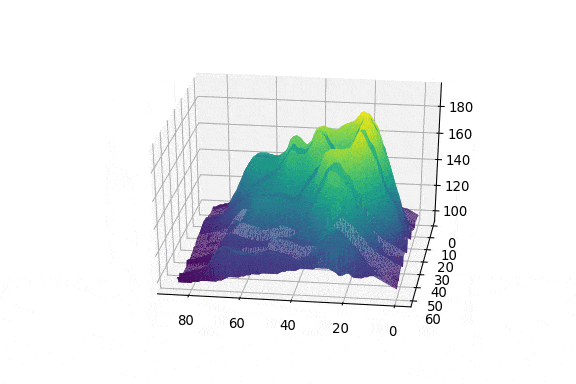
Matplotlib to tylko jedna z wielu bibliotek Pythona wspierających wizualizację danych
Źródło: Towardsdatascience.com
Python w analizie danych: zalety i wady
Znalezienie idealnego języka do analizy danych jest niemal niemożliwe, bo każdy ma swoje zalety i wady. Jeden lepiej radzi sobie z wizualizacją, inny szybciej obsługuje duże zbiory danych. Wybór zależy też od preferencji programisty. Przyjrzyjmy się bliżej zaletom i wadom Pythona w data science.
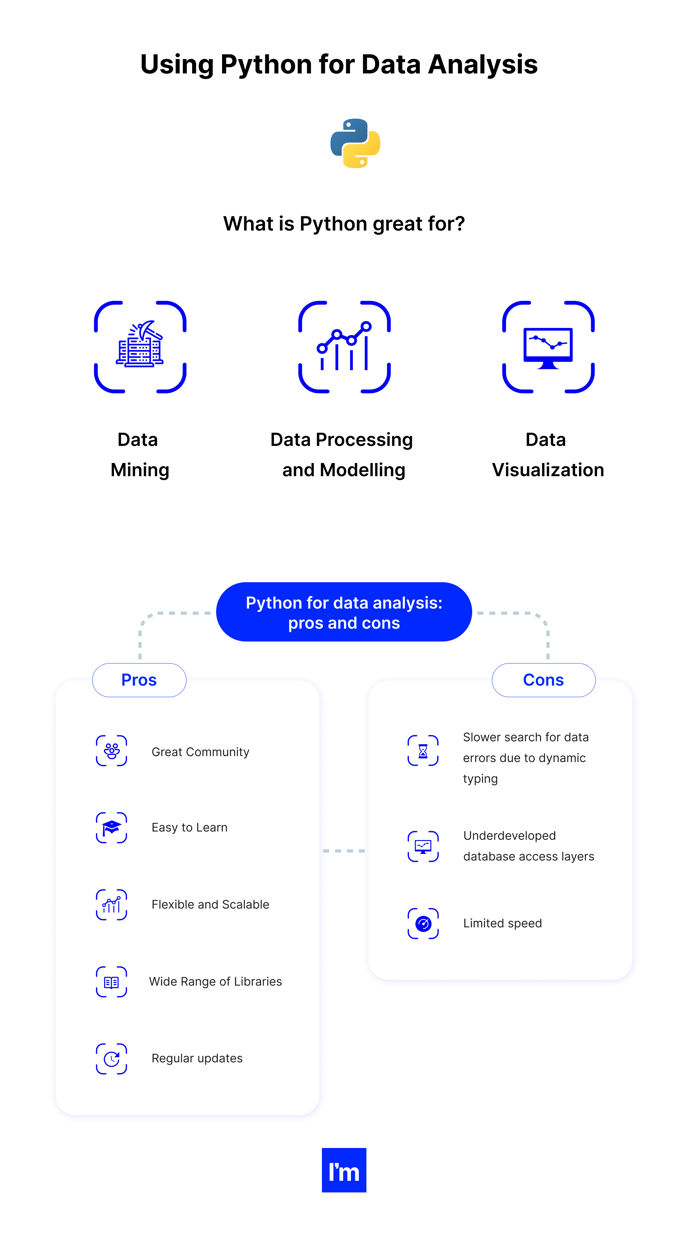
Zalety używania Pythona w analizie danych
Świetna społeczność
Programowanie nigdy nie było łatwe i nawet programiści z wieloletnim doświadczeniem czasem się męczą. Na szczęście każdy język ma lojalną społeczność, która pomaga znaleźć rozwiązania. Python jest z nami już od dłuższego czasu i łączy wielu programistów Python dzięki zastosowaniom w wielu dziedzinach IT. Oferuje ponad 90 000 repozytoriów na GitHubie. Dzięki temu, jeśli programista utknie, ma większe szanse szybko i bez wysiłku znaleźć rozwiązanie z pomocą społeczności.
Łatwy do nauki
Python jest jednym z najłatwiejszych języków do nauki, dzięki przejrzystej składni i czytelności. Wymaga też mniej linii kodu! Dzięki temu można szybko nauczyć się języka i wskoczyć w projekty analizy danych. Dodatkową zaletą przejrzystej składni i łatwej czytelności jest sama szybkość pracy: programista nie musi się zbyt wiele zastanawiać przy pisaniu, a debugowanie kodu jest łatwiejsze.
Elastyczny i skalowalny
Pythona można używać w wielu dziedzinach i projektach, działa szybciej dzięki ogromnej elastyczności i sprawdzi się z dowolnym narzędziem do szybkiego tworzenia aplikacji.
Szeroki wybór bibliotek
Jak już widziałeś, na każdy etap analizy danych przypada kilka bibliotek. Co więcej, są darmowe, co może obniżyć budżet analizy danych. Dzięki silnemu wsparciu Pythona wciąż się rozwijają i stale dodają funkcje potrzebne do wygodnej pracy z danymi.
Wady używania Pythona w analizie danych
Dynamiczne typowanie
Python to język ogólnego przeznaczenia i nie zaprojektowano go wyłącznie do analizy danych: służy też do tworzenia programów, oprogramowania czy stron. Dynamiczne typowanie ułatwia pracę, co świetnie sprawdza się w wielu zastosowaniach Pythona. W analizie danych jest to jednak wada, bo spowalnia wyszukiwanie błędów związanych z przypisywaniem różnych danych do tej samej zmiennej.
Alternatywy dla Pythona w analizie danych
Choć Python jest jednym z głównych języków analizy danych, istnieją inne opcje. Każdy język mocno akcentuje konkretne zadanie (eksplorację, wizualizację albo pracę z dużymi zbiorami danych), a niektóre powstały wyłącznie do analizy danych i obliczeń statystycznych, co oznacza zebranie najlepszych funkcji potrzebnych w tym procesie.
R
R to drugi najpopularniejszy język analizy danych i bywa często porównywany z Pythonem. Powstał do obliczeń statystycznych i grafiki, co idealnie pasuje do analizy danych. R oferuje świetne narzędzia do wizualizacji danych, jest kompatybilny z dowolną aplikacją statystyczną, można go używać offline, a programiści mają dostęp do bogatego pakietu oprogramowania do manipulacji danymi i tworzenia wykresów.
SQL
SQL jest szeroko używany do odpytywania i edycji danych. To także świetne i sprawdzone narzędzie do przechowywania i pobierania danych. Ogólnie język ten doskonale radzi sobie z dużymi bazami i pobiera informacje z sieci szybciej niż inne języki.
Julia
Julia powstała z myślą o data science i obliczeniach naukowych. To stosunkowo nowy język, ale szybko zyskuje popularność wśród data scientistów. Głównym celem języka jest pokonanie wad, jakie Python pokazał w analizie danych, i stanie się pierwszym wyborem inżynierów danych. Julia jest kompilowana, co daje wyższą wydajność, ma składnię podobną do Pythona, ale bardziej przyjazną matematyce, i potrafi korzystać z bibliotek Pythona, C i Fortonu. Język słynie też z obliczeń równoległych, które są szybsze i bardziej dopracowane niż w Pythonie.
Scala
Scala i jej framework Spark są często używane w projektach z bazami o dużej objętości i są uwielbiane przez inżynierów BigData. Nie musisz pobierać całego zbioru danych - możesz pracować na jego fragmentach. Scala działa na JVM i łatwo osadzić ją w kodzie korporacyjnym. Ma wiele narzędzi do transformacji danych i jest szybsza od Pythona i R przy jawnych pętlach.
Te 4 języki są najpopularniejsze wśród data scientistów i analityków. Warto jednak zauważyć, że mogą też sięgać po MATLAB do analiz statystycznych, TensorFlow do Big Data, grafów i obliczeń równoległych albo JavaScript do lepszej wizualizacji.
Podsumowanie
Dane stały się kluczowym elementem każdego biznesu, który chce mieć przewagę konkurencyjną na rynku i podejmować świadome decyzje.
Do analizy danych używa się wielu języków: R, SQL, Julia i Scala to najczęstsze wybory. Każdy język robi pewne rzeczy w procesie pracy z danymi lepiej od innych. Ogólnie nie ma języka idealnego - jest tylko ten lepiej pasujący do Twojego projektu.
Mimo to Python pozostaje najpopularniejszym językiem analizy danych. Ma liczne biblioteki wspierające analityków na każdym kroku, świetną społeczność, która pomoże, gdy coś nie idzie gładko, i należy do najłatwiejszych języków do nauki.
Jeśli chcesz zbudować biznes oparty na danych i szukasz programisty Pythona, który Ci w tym pomoże, śmiało skontaktuj się z nami! Programiści Ideamotive mają rozległe doświadczenie z Pythonem i zapewnią eksperckie wsparcie w każdym zadaniu programistycznym.
Michał Pruciak doradza liderom firm technologicznych. Zna się na rozwoju biznesu i lubi łączyć technologie medyczne z najnowszymi rozwiązaniami. Myśli strategicznie i potrafi krytycznie spojrzeć na problem. Po pracy ogląda filmy i chodzi po górach, bo ruch pomaga mu zachować równowagę.
Zobacz wszystkie wpisy autora
Popularne artykuły
21 inspirujących projektów UI aplikacji mobilnych na 2023 rok
Michał Pruciak 7 min czytania
MedTech vs HealthTech vs BioTech: jakie są różnice?
Michał Pruciak 7 min czytania
10 biznesowych zastosowań sieci neuronowych (z przykładami!)
Michał Pruciak 4 min czytania
10 przykładów dobrych praktyk w web designie na 2023 rok
Adam Kozłowski 7 min czytania
28 znanych aplikacji webowych napisanych w PHP
Dawid Karczewski 14 min czytania
Jakich usług programistycznych szukasz?
Szukasz ekspertów od AI do swojego zespołu?
W naszej sieci talentów czekają dziesiątki zweryfikowanych specjalistów AI.


Porozmawiaj z autorem artykułu